
Tutorial 21: Sensitivity Analysis and Uncertainty Quantification#
This tutorial covers how to use JAX’s automatic differentiation for sensitivity analysis and uncertainty quantification (UQ) in chemical engineering models. We’ll explore:
Local sensitivity analysis via gradients
Linear error propagation using Jacobians
Global sensitivity analysis (Sobol indices)
Monte Carlo uncertainty propagation
Gradient-enhanced Monte Carlo
Covariance propagation through nonlinear models
Chemical engineering example: Flowsheet uncertainty analysis
import jax
import jax.numpy as jnp
from jax import grad, jacobian, vmap, jit
import optax
import matplotlib.pyplot as plt
from functools import partial

jax.config.update('jax_enable_x64', True)
1. Local Sensitivity Analysis via Gradients#
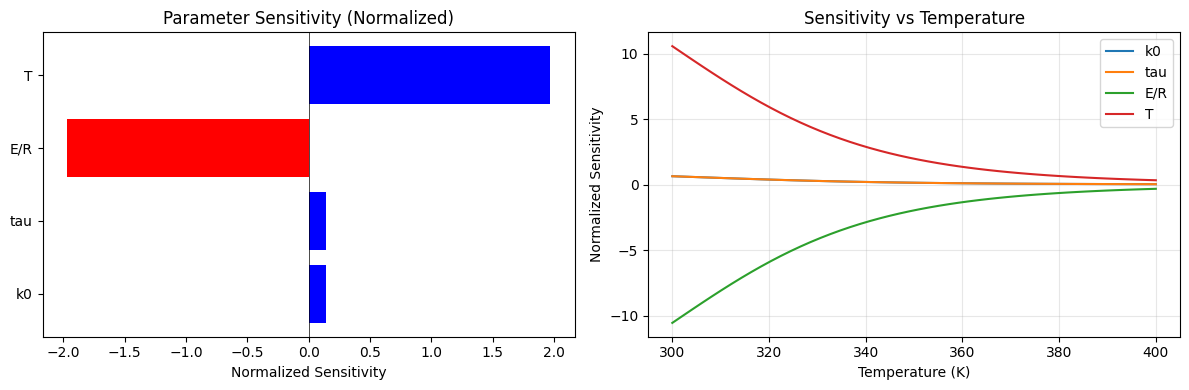
Local sensitivity measures how outputs change with respect to small parameter perturbations:
Normalized sensitivities allow comparison across parameters with different scales:
# Example: CSTR steady-state model
def cstr_conversion(params, inlet_conc=1.0):
    """Calculate conversion in a CSTR.

    params: [k, tau, E_over_R, T]
        k: pre-exponential factor
        tau: residence time
        E_over_R: activation energy / R
        T: temperature
    """
    k0, tau, E_over_R, T = params
    k = k0 * jnp.exp(-E_over_R / T)  # Arrhenius
    # Steady-state CSTR: X = k*tau / (1 + k*tau)
    conversion = k * tau / (1 + k * tau)
    return conversion

# Nominal parameters
params_nominal = jnp.array([1e6, 10.0, 5000.0, 350.0])
param_names = ['k0', 'tau', 'E/R', 'T']

# Calculate sensitivities
sensitivities = grad(cstr_conversion)(params_nominal)

# Calculate normalized sensitivities
y_nominal = cstr_conversion(params_nominal)
normalized_sens = (params_nominal / y_nominal) * sensitivities

print("CSTR Conversion Sensitivity Analysis")
print("=" * 40)
print(f"Nominal conversion: {y_nominal:.4f}")
print("\nLocal sensitivities (dy/dp):")
for name, s in zip(param_names, sensitivities):
    print(f"  {name:>6}: {s:+.6e}")
print("\nNormalized sensitivities (p/y * dy/dp):")
for name, s in zip(param_names, normalized_sens):
    print(f"  {name:>6}: {s:+.4f}")
WARNING:2026-01-10 20:59:54,430:jax._src.xla_bridge:852: An NVIDIA GPU may be present on this machine, but a CUDA-enabled jaxlib is not installed. Falling back to cpu.
CSTR Conversion Sensitivity Analysis
========================================
Nominal conversion: 0.8620

Local sensitivities (dy/dp):
      k0: +1.189233e-07
     tau: +1.189233e-02
     E/R: -3.397808e-04
       T: +4.854012e-03

Normalized sensitivities (p/y * dy/dp):
      k0: +0.1380
     tau: +0.1380
     E/R: -1.9708
       T: +1.9708
# Visualize sensitivities
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4))

colors = ['blue' if s > 0 else 'red' for s in normalized_sens]
ax1.barh(param_names, normalized_sens, color=colors)
ax1.axvline(0, color='black', linewidth=0.5)
ax1.set_xlabel('Normalized Sensitivity')
ax1.set_title('Parameter Sensitivity (Normalized)')

# Sensitivity across temperature range
T_range = jnp.linspace(300, 400, 50)
def sens_vs_T(T):
    params = params_nominal.at[3].set(T)
    y = cstr_conversion(params)
    s = grad(cstr_conversion)(params)
    return y, (params / y) * s

conversions, sens_matrix = vmap(sens_vs_T)(T_range)

for i, name in enumerate(param_names):
    ax2.plot(T_range, sens_matrix[:, i], label=name)
ax2.set_xlabel('Temperature (K)')
ax2.set_ylabel('Normalized Sensitivity')
ax2.set_title('Sensitivity vs Temperature')
ax2.legend()
ax2.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
2. Linear Error Propagation Using Jacobians#
For small uncertainties, we can propagate covariance through the Jacobian:
where \(J = \partial y / \partial p\) is the Jacobian and \(\Sigma_p\) is the parameter covariance.
def cstr_outputs(params, inlet_conc=1.0):
    """Multiple CSTR outputs: [conversion, outlet_conc, heat_duty]."""
    k0, tau, E_over_R, T = params
    k = k0 * jnp.exp(-E_over_R / T)

    conversion = k * tau / (1 + k * tau)
    outlet_conc = inlet_conc * (1 - conversion)

    # Heat duty (simplified): Q = Delta_H * r * V
    delta_H = -50000.0  # J/mol (exothermic)
    rate = k * outlet_conc
    V = tau  # Assume volumetric flow = 1
    heat_duty = -delta_H * rate * V  # Heat to remove

    return jnp.array([conversion, outlet_conc, heat_duty])

# Calculate Jacobian
J = jacobian(cstr_outputs)(params_nominal)
print("Jacobian (3 outputs x 4 parameters):")
print(J)

# Define parameter uncertainties (standard deviations)
param_std = jnp.array([1e5, 0.5, 200.0, 5.0])  # 10%, 5%, 4%, 1.4%
Sigma_p = jnp.diag(param_std**2)  # Assume uncorrelated

# Propagate uncertainty
Sigma_y = J @ Sigma_p @ J.T
output_std = jnp.sqrt(jnp.diag(Sigma_y))

output_names = ['Conversion', 'Outlet Conc', 'Heat Duty']
y_nominal = cstr_outputs(params_nominal)

print("\nLinear Error Propagation Results:")
print("=" * 50)
for name, y, std in zip(output_names, y_nominal, output_std):
    rel_std = 100 * std / abs(y) if abs(y) > 1e-10 else 0
    print(f"{name:>12}: {y:10.4f} +/- {std:.4f} ({rel_std:.1f}%)")
Jacobian (3 outputs x 4 parameters):
[[ 1.18923294e-07  1.18923294e-02 -3.39780841e-04  4.85401201e-03]
 [-1.18923294e-07 -1.18923294e-02  3.39780841e-04 -4.85401201e-03]
 [ 5.94616471e-03  5.94616471e+02 -1.69890420e+01  2.42700601e+02]]
Linear Error Propagation Results:
==================================================
  Conversion:     0.8620 +/- 0.0734 (8.5%)
 Outlet Conc:     0.1380 +/- 0.0734 (53.2%)
   Heat Duty: 43102.2585 +/- 3668.7399 (8.5%)
# Contribution analysis: which parameters contribute most to output uncertainty?
def uncertainty_contribution(J, param_variances):
    """Calculate fractional contribution of each parameter to output variance."""
    contributions = []
    for i in range(J.shape[0]):  # For each output
        var_contributions = (J[i, :]**2) * param_variances
        total_var = var_contributions.sum()
        frac_contributions = var_contributions / total_var
        contributions.append(frac_contributions)
    return jnp.array(contributions)

contributions = uncertainty_contribution(J, param_std**2)

print("Uncertainty Contribution Analysis:")
print("=" * 60)
print(f"{'Output':<15} " + " ".join(f"{p:>10}" for p in param_names))
print("-" * 60)
for i, output in enumerate(output_names):
    row = " ".join(f"{100*c:>9.1f}%" for c in contributions[i])
    print(f"{output:<15} {row}")
Uncertainty Contribution Analysis:
============================================================
Output                  k0        tau        E/R          T
------------------------------------------------------------
Conversion            2.6%       0.7%      85.8%      10.9%
Outlet Conc           2.6%       0.7%      85.8%      10.9%
Heat Duty             2.6%       0.7%      85.8%      10.9%
3. Global Sensitivity Analysis (Sobol Indices)#
Global sensitivity analysis explores the entire parameter space, not just local perturbations. Sobol indices decompose output variance by parameter contributions.
First-order Sobol index: $\(S_i = \frac{V[E[Y|X_i]]}{V[Y]}\)$
def sobol_indices_saltelli(model, param_bounds, n_samples=1024, key=jax.random.PRNGKey(0)):
    """
    Estimate first-order Sobol indices using Saltelli's method.

    param_bounds: array of shape (n_params, 2) with [low, high] for each param
    """
    n_params = len(param_bounds)

    # Generate two independent sample matrices
    key1, key2 = jax.random.split(key)
    A = jax.random.uniform(key1, (n_samples, n_params))
    B = jax.random.uniform(key2, (n_samples, n_params))

    # Scale to parameter bounds
    low = param_bounds[:, 0]
    high = param_bounds[:, 1]
    A_scaled = low + A * (high - low)
    B_scaled = low + B * (high - low)

    # Evaluate model on A and B
    f_A = vmap(model)(A_scaled)
    f_B = vmap(model)(B_scaled)

    # Calculate total variance
    f_all = jnp.concatenate([f_A, f_B])
    var_total = jnp.var(f_all)

    # First-order indices
    S1 = []
    for i in range(n_params):
        # Create AB_i: A with i-th column replaced by B's i-th column
        AB_i = A_scaled.at[:, i].set(B_scaled[:, i])
        f_AB_i = vmap(model)(AB_i)

        # Estimate V[E[Y|X_i]] using Jansen estimator
        V_i = jnp.mean(f_B * (f_AB_i - f_A))
        S1.append(V_i / var_total)

    return jnp.array(S1)

# Define parameter bounds (uniform distributions)
param_bounds = jnp.array([
    [5e5, 2e6],      # k0
    [5.0, 20.0],     # tau
    [4000.0, 6000.0], # E/R
    [320.0, 380.0]   # T
])

# Calculate Sobol indices
sobol_S1 = sobol_indices_saltelli(cstr_conversion, param_bounds, n_samples=2048)

print("Global Sensitivity Analysis (Sobol First-Order Indices):")
print("=" * 50)
for name, s in zip(param_names, sobol_S1):
    bar = '#' * int(s * 40)
    print(f"{name:>6}: {s:.3f} |{bar}")
print(f"\nSum of S1: {sobol_S1.sum():.3f} (should be ~1 for additive models)")
Global Sensitivity Analysis (Sobol First-Order Indices):
==================================================
    k0: 0.039 |#
   tau: 0.057 |##
   E/R: 0.708 |############################
     T: 0.137 |#####

Sum of S1: 0.942 (should be ~1 for additive models)
4. Monte Carlo Uncertainty Propagation#
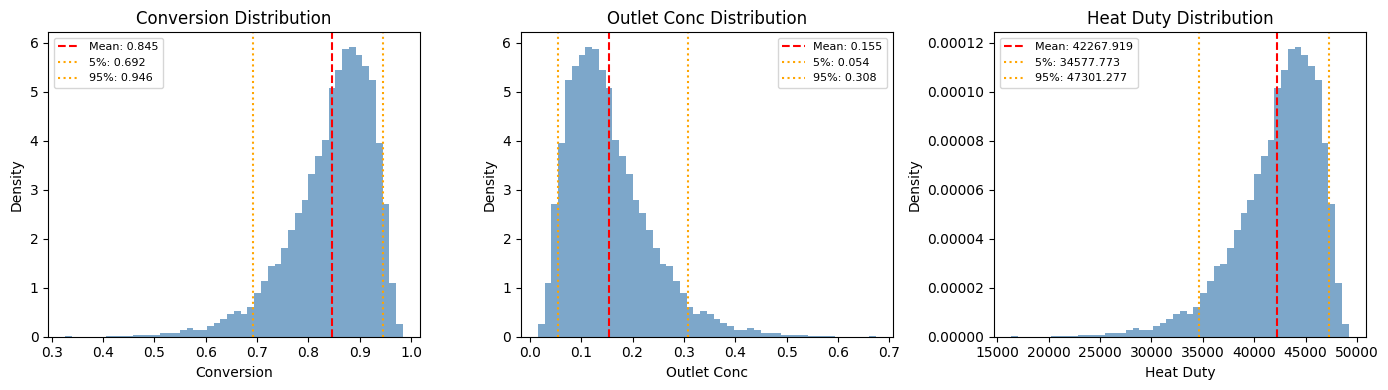
For nonlinear models with large uncertainties, Monte Carlo sampling provides accurate uncertainty estimates.
def monte_carlo_uq(model, param_mean, param_cov, n_samples=10000, key=jax.random.PRNGKey(0)):
    """
    Monte Carlo uncertainty propagation.

    Returns samples from output distribution.
    """
    # Sample from multivariate normal
    n_params = len(param_mean)

    # Cholesky decomposition for sampling
    L = jnp.linalg.cholesky(param_cov)
    z = jax.random.normal(key, (n_samples, n_params))
    param_samples = param_mean + z @ L.T

    # Evaluate model for all samples
    output_samples = vmap(model)(param_samples)

    return param_samples, output_samples

# Run Monte Carlo
param_cov = jnp.diag(param_std**2)
param_samples, output_samples = monte_carlo_uq(
    cstr_outputs, params_nominal, param_cov, n_samples=10000
)

# Statistics
mc_mean = jnp.mean(output_samples, axis=0)
mc_std = jnp.std(output_samples, axis=0)
mc_percentiles = jnp.percentile(output_samples, jnp.array([5, 50, 95]), axis=0)

print("Monte Carlo UQ Results (10,000 samples):")
print("=" * 60)
print(f"{'Output':<15} {'Mean':>10} {'Std':>10} {'5%':>10} {'95%':>10}")
print("-" * 60)
for i, name in enumerate(output_names):
    print(f"{name:<15} {mc_mean[i]:>10.4f} {mc_std[i]:>10.4f} "
          f"{mc_percentiles[0, i]:>10.4f} {mc_percentiles[2, i]:>10.4f}")
Monte Carlo UQ Results (10,000 samples):
============================================================
Output                Mean        Std         5%        95%
------------------------------------------------------------
Conversion          0.8454     0.0811     0.6916     0.9460
Outlet Conc         0.1546     0.0811     0.0540     0.3084
Heat Duty       42267.9194  4053.7858 34577.7732 47301.2774
# Visualize output distributions
fig, axes = plt.subplots(1, 3, figsize=(14, 4))

for i, (ax, name) in enumerate(zip(axes, output_names)):
    ax.hist(output_samples[:, i], bins=50, density=True, alpha=0.7, color='steelblue')
    ax.axvline(mc_mean[i], color='red', linestyle='--', label=f'Mean: {mc_mean[i]:.3f}')
    ax.axvline(mc_percentiles[0, i], color='orange', linestyle=':', label=f'5%: {mc_percentiles[0, i]:.3f}')
    ax.axvline(mc_percentiles[2, i], color='orange', linestyle=':', label=f'95%: {mc_percentiles[2, i]:.3f}')
    ax.set_xlabel(name)
    ax.set_ylabel('Density')
    ax.legend(fontsize=8)
    ax.set_title(f'{name} Distribution')

plt.tight_layout()
plt.show()
5. Gradient-Enhanced Monte Carlo#
We can use gradients to accelerate Monte Carlo convergence via control variates.
def gradient_enhanced_mc(model, param_mean, param_cov, n_samples=1000, key=jax.random.PRNGKey(0)):
    """
    Gradient-enhanced Monte Carlo using linear control variates.

    Uses first-order Taylor expansion as control variate:
    f(x) ≈ f(mu) + grad(f)(mu) @ (x - mu)

    Estimator: f_bar = f(mu) + mean(f(x) - f_linear(x))
    """
    n_params = len(param_mean)

    # Sample parameters
    L = jnp.linalg.cholesky(param_cov)
    z = jax.random.normal(key, (n_samples, n_params))
    param_samples = param_mean + z @ L.T

    # Evaluate model and gradient at mean
    f_mean = model(param_mean)
    grad_f = jacobian(model)(param_mean)

    # Evaluate model at samples
    f_samples = vmap(model)(param_samples)

    # Linear approximation (control variate)
    delta_params = param_samples - param_mean
    f_linear = f_mean + delta_params @ grad_f.T

    # Corrected estimate
    corrections = f_samples - f_linear
    f_enhanced = f_mean + jnp.mean(corrections, axis=0)

    # Variance of corrections (should be smaller than raw variance)
    var_raw = jnp.var(f_samples, axis=0)
    var_enhanced = jnp.var(corrections, axis=0)

    return f_enhanced, var_raw, var_enhanced

# Compare standard vs gradient-enhanced MC
n_samples_list = [100, 500, 1000, 5000]
results = []

for n in n_samples_list:
    f_enh, var_raw, var_enh = gradient_enhanced_mc(
        cstr_outputs, params_nominal, param_cov, n_samples=n
    )
    variance_reduction = var_raw / (var_enh + 1e-10)
    results.append((n, variance_reduction))

print("Variance Reduction from Gradient-Enhanced MC:")
print("=" * 60)
print(f"{'Samples':<10} " + " ".join(f"{name:>15}" for name in output_names))
print("-" * 60)
for n, vr in results:
    row = " ".join(f"{v:>14.1f}x" for v in vr)
    print(f"{n:<10} {row}")
Variance Reduction from Gradient-Enhanced MC:
============================================================
Samples         Conversion     Outlet Conc       Heat Duty
------------------------------------------------------------
100                  11.4x           11.4x           11.4x
500                  13.1x           13.1x           13.1x
1000                 11.8x           11.8x           11.8x
5000                 12.8x           12.8x           12.8x
6. Covariance Propagation Through Nonlinear Models#
For strongly nonlinear models, we can use second-order (Hessian) corrections.
def second_order_propagation(model, param_mean, param_cov):
    """
    Second-order uncertainty propagation including mean bias correction.

    E[f(x)] ≈ f(mu) + 0.5 * trace(H @ Sigma)
    Var[f(x)] ≈ grad^T @ Sigma @ grad
    """
    # First-order terms
    f_mean = model(param_mean)
    grad_f = grad(model)(param_mean)

    # Second-order term (Hessian)
    hess_f = jax.hessian(model)(param_mean)

    # Mean correction: 0.5 * trace(H @ Sigma)
    mean_correction = 0.5 * jnp.trace(hess_f @ param_cov)
    corrected_mean = f_mean + mean_correction

    # Variance (first-order)
    variance = grad_f @ param_cov @ grad_f

    return corrected_mean, jnp.sqrt(variance), mean_correction

# Compare first and second order for conversion
first_order_mean = cstr_conversion(params_nominal)
first_order_std = jnp.sqrt(grad(cstr_conversion)(params_nominal) @ param_cov @ grad(cstr_conversion)(params_nominal))

second_order_mean, second_order_std, bias = second_order_propagation(
    cstr_conversion, params_nominal, param_cov
)

# Monte Carlo reference
_, mc_samples = monte_carlo_uq(cstr_conversion, params_nominal, param_cov, n_samples=50000)
mc_ref_mean = jnp.mean(mc_samples)
mc_ref_std = jnp.std(mc_samples)

print("Comparison of Uncertainty Propagation Methods:")
print("=" * 55)
print(f"{'Method':<25} {'Mean':>12} {'Std':>12}")
print("-" * 55)
print(f"{'First-order (linear)':<25} {first_order_mean:>12.6f} {first_order_std:>12.6f}")
print(f"{'Second-order (quadratic)':<25} {second_order_mean:>12.6f} {second_order_std:>12.6f}")
print(f"{'Monte Carlo (50k)':<25} {mc_ref_mean:>12.6f} {mc_ref_std:>12.6f}")
print(f"\nSecond-order mean bias correction: {bias:.6f}")
Comparison of Uncertainty Propagation Methods:
=======================================================
Method                            Mean          Std
-------------------------------------------------------
First-order (linear)          0.862045     0.073375
Second-order (quadratic)      0.844565     0.073375
Monte Carlo (50k)             0.845561     0.080513

Second-order mean bias correction: -0.017480
7. Chemical Engineering Example: Flowsheet Uncertainty Analysis#
Let’s analyze uncertainty propagation through a multi-unit flowsheet.
class FlowsheetUQ:
    """A simple reaction-separation flowsheet for UQ analysis."""

    @staticmethod
    def simulate(params):
        """
        Simulate flowsheet with uncertain parameters.

        params: [k_rxn, E_over_R, T_rxn, alpha_sep, T_sep, recycle_frac]

        Returns: [product_purity, yield, energy_consumption]
        """
        k_rxn, E_over_R, T_rxn, alpha_sep, T_sep, recycle_frac = params

        # Feed
        F_feed = 100.0  # mol/s

        # Reactor (CSTR)
        k = k_rxn * jnp.exp(-E_over_R / T_rxn)
        tau = 10.0

        # Iteratively solve recycle (simplified)
        def recycle_iteration(carry, _):
            F_recycle = carry
            F_reactor_in = F_feed + F_recycle
            X = k * tau / (1 + k * tau)
            F_product_raw = F_reactor_in * X
            F_unreacted = F_reactor_in * (1 - X)

            # Separator
            separation_eff = 1 - jnp.exp(-alpha_sep * (T_sep - 300) / 50)
            separation_eff = jnp.clip(separation_eff, 0.5, 0.99)

            F_product_pure = F_product_raw * separation_eff
            F_recycle_new = F_unreacted * recycle_frac

            return F_recycle_new, (F_product_pure, F_unreacted, separation_eff)

        # Run recycle to steady state
        F_recycle_init = 10.0
        F_recycle_final, (F_product, F_unreacted, sep_eff) = jax.lax.scan(
            recycle_iteration, F_recycle_init, None, length=20
        )
        F_product = F_product[-1]
        sep_eff = sep_eff[-1]

        # Calculate outputs
        product_purity = sep_eff  # Simplified
        yield_frac = F_product / F_feed

        # Energy consumption (heating + separation)
        Q_reactor = 50.0 * (T_rxn - 300)  # kW
        Q_separator = 30.0 * (T_sep - 300)  # kW
        energy = Q_reactor + Q_separator

        return jnp.array([product_purity, yield_frac, energy])

# Nominal parameters and uncertainties
flowsheet_params = jnp.array([
    1e5,    # k_rxn
    5000.0, # E_over_R
    350.0,  # T_rxn
    2.0,    # alpha_sep
    340.0,  # T_sep
    0.8     # recycle_frac
])

flowsheet_param_names = ['k_rxn', 'E/R', 'T_rxn', 'alpha', 'T_sep', 'recycle']
flowsheet_output_names = ['Purity', 'Yield', 'Energy (kW)']

# Parameter uncertainties (relative)
rel_uncertainties = jnp.array([0.20, 0.05, 0.02, 0.15, 0.02, 0.05])
flowsheet_std = flowsheet_params * rel_uncertainties
flowsheet_cov = jnp.diag(flowsheet_std**2)

# Local sensitivity analysis
J_flowsheet = jacobian(FlowsheetUQ.simulate)(flowsheet_params)
y_nominal = FlowsheetUQ.simulate(flowsheet_params)

# Normalized sensitivities
norm_sens = (flowsheet_params / y_nominal[:, None]) * J_flowsheet

print("Flowsheet Sensitivity Analysis:")
print("=" * 80)
print(f"{'Output':<15} " + " ".join(f"{p:>10}" for p in flowsheet_param_names))
print("-" * 80)
for i, output in enumerate(flowsheet_output_names):
    row = " ".join(f"{s:>10.3f}" for s in norm_sens[i])
    print(f"{output:<15} {row}")
Flowsheet Sensitivity Analysis:
================================================================================
Output               k_rxn        E/R      T_rxn      alpha      T_sep    recycle
--------------------------------------------------------------------------------
Purity               0.000      0.000      0.000      0.405      3.440      0.000
Yield                0.242     -3.464      3.464      0.405      3.440      0.970
Energy (kW)          0.000      0.000      4.730      0.000      2.757      0.000
# Full Monte Carlo analysis
key = jax.random.PRNGKey(42)
n_mc = 5000

L = jnp.linalg.cholesky(flowsheet_cov)
z = jax.random.normal(key, (n_mc, len(flowsheet_params)))
param_samples = flowsheet_params + z @ L.T

# Ensure physical constraints
param_samples = param_samples.at[:, 0].set(jnp.maximum(param_samples[:, 0], 1e3))  # k > 0
param_samples = param_samples.at[:, 5].set(jnp.clip(param_samples[:, 5], 0.1, 0.95))  # recycle in [0,1]

output_samples = vmap(FlowsheetUQ.simulate)(param_samples)

# Statistics
mc_stats = {
    'mean': jnp.mean(output_samples, axis=0),
    'std': jnp.std(output_samples, axis=0),
    'p5': jnp.percentile(output_samples, 5, axis=0),
    'p95': jnp.percentile(output_samples, 95, axis=0)
}

print("\nFlowsheet Monte Carlo UQ Results:")
print("=" * 70)
print(f"{'Output':<15} {'Nominal':>10} {'Mean':>10} {'Std':>10} {'5%':>10} {'95%':>10}")
print("-" * 70)
for i, name in enumerate(flowsheet_output_names):
    print(f"{name:<15} {y_nominal[i]:>10.3f} {mc_stats['mean'][i]:>10.3f} "
          f"{mc_stats['std'][i]:>10.3f} {mc_stats['p5'][i]:>10.3f} {mc_stats['p95'][i]:>10.3f}")
Flowsheet Monte Carlo UQ Results:
======================================================================
Output             Nominal       Mean        Std         5%        95%
----------------------------------------------------------------------
Purity               0.798      0.786      0.075      0.650      0.893
Yield                0.605      0.575      0.128      0.345      0.763
Energy (kW)       3700.000   3707.813    404.947   3046.806   4356.191
# Visualize correlations between outputs
fig, axes = plt.subplots(1, 3, figsize=(14, 4))

# Purity vs Yield
axes[0].scatter(output_samples[:, 0], output_samples[:, 1], alpha=0.3, s=5)
axes[0].set_xlabel('Purity')
axes[0].set_ylabel('Yield')
axes[0].set_title('Purity vs Yield')

# Yield vs Energy
axes[1].scatter(output_samples[:, 1], output_samples[:, 2], alpha=0.3, s=5)
axes[1].set_xlabel('Yield')
axes[1].set_ylabel('Energy (kW)')
axes[1].set_title('Yield vs Energy')

# Purity vs Energy
axes[2].scatter(output_samples[:, 0], output_samples[:, 2], alpha=0.3, s=5)
axes[2].set_xlabel('Purity')
axes[2].set_ylabel('Energy (kW)')
axes[2].set_title('Purity vs Energy')

for ax in axes:
    ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()

# Output correlation matrix
corr_matrix = jnp.corrcoef(output_samples.T)
print("\nOutput Correlation Matrix:")
print("=" * 50)
print(f"{'':>15} " + " ".join(f"{n:>12}" for n in flowsheet_output_names))
for i, name in enumerate(flowsheet_output_names):
    row = " ".join(f"{corr_matrix[i, j]:>12.3f}" for j in range(3))
    print(f"{name:>15} {row}")
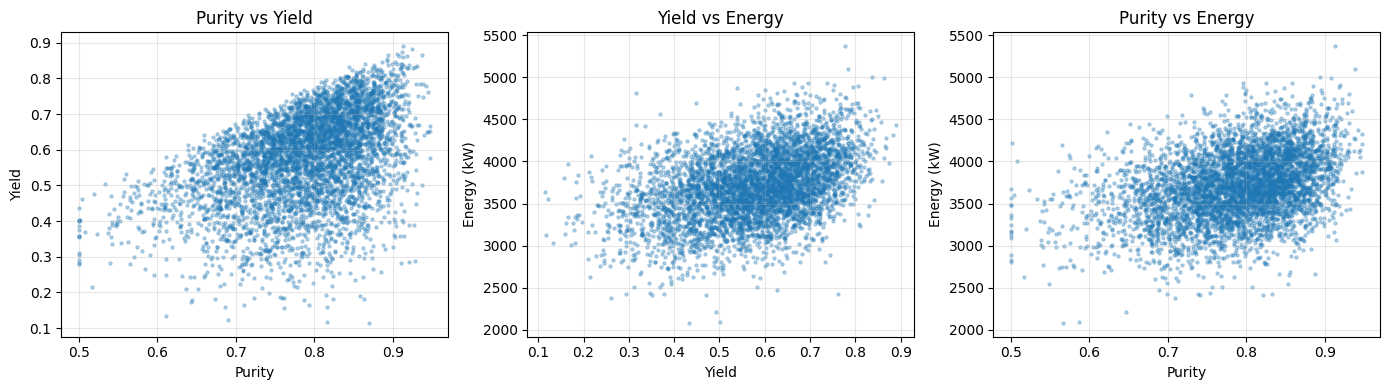
Output Correlation Matrix:
==================================================
                      Purity        Yield  Energy (kW)
         Purity        1.000        0.446        0.370
          Yield        0.446        1.000        0.407
    Energy (kW)        0.370        0.407        1.000
# Probability of meeting specifications
purity_spec = 0.90
yield_spec = 0.70
energy_spec = 4000.0

meets_purity = output_samples[:, 0] >= purity_spec
meets_yield = output_samples[:, 1] >= yield_spec
meets_energy = output_samples[:, 2] <= energy_spec
meets_all = meets_purity & meets_yield & meets_energy

print("Probability of Meeting Specifications:")
print("=" * 50)
print(f"Purity >= {purity_spec:.0%}: {meets_purity.mean():.1%}")
print(f"Yield >= {yield_spec:.0%}: {meets_yield.mean():.1%}")
print(f"Energy <= {energy_spec:.0f} kW: {meets_energy.mean():.1%}")
print(f"\nAll specifications: {meets_all.mean():.1%}")
Probability of Meeting Specifications:
==================================================
Purity >= 90%: 3.6%
Yield >= 70%: 16.6%
Energy <= 4000 kW: 76.3%

All specifications: 0.6%
Summary#
This tutorial covered sensitivity analysis and uncertainty quantification using JAX:
Method |
Use Case |
JAX Tools |
|---|---|---|
Local sensitivity |
Small perturbations, ranking parameters |
|
Linear propagation |
Small uncertainties, Gaussian inputs |
|
Global sensitivity (Sobol) |
Large parameter ranges, non-linear models |
|
Monte Carlo |
Any distribution, accurate confidence intervals |
|
Gradient-enhanced MC |
Variance reduction, faster convergence |
|
Second-order propagation |
Strong nonlinearity, mean bias correction |
|
Key Takeaways#
Gradients are cheap: JAX’s autodiff makes sensitivity analysis nearly free
vmap enables fast Monte Carlo: Vectorized evaluation over thousands of samples
Combine methods: Use local sensitivity for screening, MC for final UQ
Check linearity: Compare first and second-order propagation to assess nonlinearity
Consider correlations: Output uncertainties may be correlated even with uncorrelated inputs