
Optax: Gradient-Based Optimization in JAX#
This tutorial covers optax, the standard library for gradient-based optimization in JAX.
What You’ll Learn#
Basic optax workflow (init, update, apply)
Common optimizers (SGD, Adam, RMSprop, etc.)
Learning rate schedules
Gradient transformations (clipping, scaling)
Combining transforms with
optax.chainPractical examples with chemical engineering applications
import jax
import jax.numpy as jnp
from jax import grad, jit, vmap
import optax
import matplotlib.pyplot as plt

jax.config.update("jax_enable_x64", True)

print(f"JAX version: {jax.__version__}")
print(f"Optax version: {optax.__version__}")
JAX version: 0.8.2
Optax version: 0.2.6
1. The Optax Workflow#
Optax uses a functional approach with three main components:
optimizer.init(params)- Initialize optimizer stateoptimizer.update(grads, state, params)- Compute parameter updatesoptax.apply_updates(params, updates)- Apply updates to parameters
This separation allows full control and composability.
# Simple example: minimize f(x) = (x - 3)^2
def loss_fn(x):
    return (x - 3.0) ** 2

# Initialize
x = jnp.array(0.0)  # Starting point
optimizer = optax.sgd(learning_rate=0.1)
opt_state = optimizer.init(x)

# Training loop
print("Step |    x    |  Loss")
print("-" * 30)

for step in range(10):
    loss = loss_fn(x)
    grads = grad(loss_fn)(x)

    # Get updates from optimizer
    updates, opt_state = optimizer.update(grads, opt_state, x)

    # Apply updates
    x = optax.apply_updates(x, updates)

    print(f"  {step:2d}  | {float(x):7.4f} | {float(loss):.4f}")

print(f"\nFinal x = {float(x):.6f} (target: 3.0)")
WARNING:2026-01-10 20:27:20,006:jax._src.xla_bridge:852: An NVIDIA GPU may be present on this machine, but a CUDA-enabled jaxlib is not installed. Falling back to cpu.
Step |    x    |  Loss
------------------------------
0 | 0.6000 | 9.0000
   1  |  1.0800 | 5.7600
   2  |  1.4640 | 3.6864
   3  |  1.7712 | 2.3593
   4  |  2.0170 | 1.5099
   5  |  2.2136 | 0.9664
   6  |  2.3709 | 0.6185
   7  |  2.4967 | 0.3958
   8  |  2.5973 | 0.2533
   9  |  2.6779 | 0.1621

Final x = 2.677877 (target: 3.0)
2. Common Optimizers#
Optax provides many standard optimizers:
Optimizer |
Use Case |
Key Feature |
|---|---|---|
|
Simple problems |
Basic gradient descent |
|
General purpose |
Adaptive learning rates |
|
Deep learning |
Adam with weight decay |
|
Non-stationary |
Adapts to recent gradients |
|
Sparse gradients |
Per-parameter learning rates |
|
Small problems |
Quasi-Newton method |
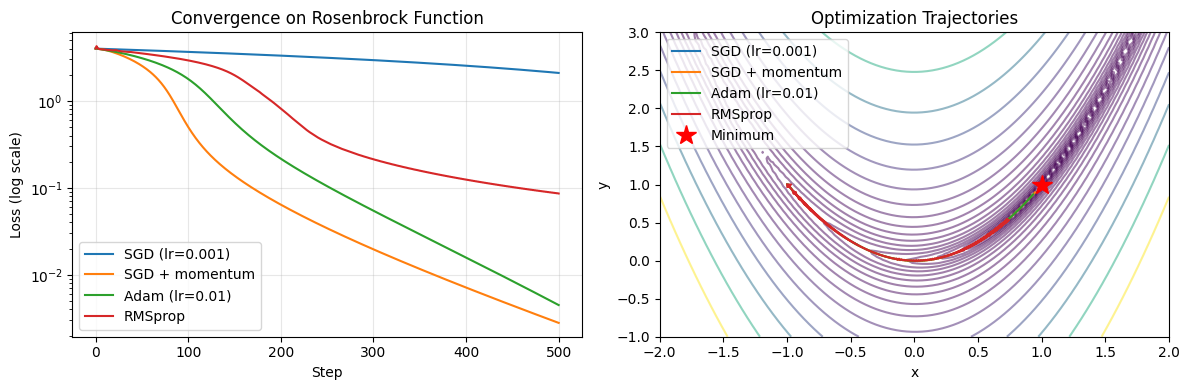
# Compare optimizers on the Rosenbrock function
def rosenbrock(params):
    """Classic optimization test function. Minimum at (1, 1)."""
    x, y = params
    return (1 - x)**2 + 100 * (y - x**2)**2

def optimize(optimizer, n_steps=500):
    """Run optimization and return trajectory."""
    params = jnp.array([-1.0, 1.0])  # Start point
    opt_state = optimizer.init(params)

    trajectory = [params]
    losses = [rosenbrock(params)]

    for _ in range(n_steps):
        grads = grad(rosenbrock)(params)
        updates, opt_state = optimizer.update(grads, opt_state, params)
        params = optax.apply_updates(params, updates)
        trajectory.append(params)
        losses.append(rosenbrock(params))

    return jnp.array(trajectory), jnp.array(losses)

# Compare different optimizers
optimizers = {
    'SGD (lr=0.001)': optax.sgd(0.001),
    'SGD + momentum': optax.sgd(0.001, momentum=0.9),
    'Adam (lr=0.01)': optax.adam(0.01),
    'RMSprop': optax.rmsprop(0.01),
}

results = {name: optimize(opt) for name, opt in optimizers.items()}
# Plot convergence
fig, axes = plt.subplots(1, 2, figsize=(12, 4))

# Loss curves
ax = axes[0]
for name, (traj, losses) in results.items():
    ax.semilogy(losses, label=name)
ax.set_xlabel('Step')
ax.set_ylabel('Loss (log scale)')
ax.set_title('Convergence on Rosenbrock Function')
ax.legend()
ax.grid(True, alpha=0.3)

# Trajectories
ax = axes[1]
x = jnp.linspace(-2, 2, 100)
y = jnp.linspace(-1, 3, 100)
X, Y = jnp.meshgrid(x, y)
Z = (1 - X)**2 + 100 * (Y - X**2)**2
ax.contour(X, Y, Z, levels=jnp.logspace(-1, 3, 20), cmap='viridis', alpha=0.5)

for name, (traj, _) in results.items():
    ax.plot(traj[:, 0], traj[:, 1], '-', label=name, linewidth=1.5)
ax.plot(1, 1, 'r*', markersize=15, label='Minimum')
ax.set_xlabel('x')
ax.set_ylabel('y')
ax.set_title('Optimization Trajectories')
ax.legend(loc='upper left')

plt.tight_layout()
plt.show()
3. Learning Rate Schedules#
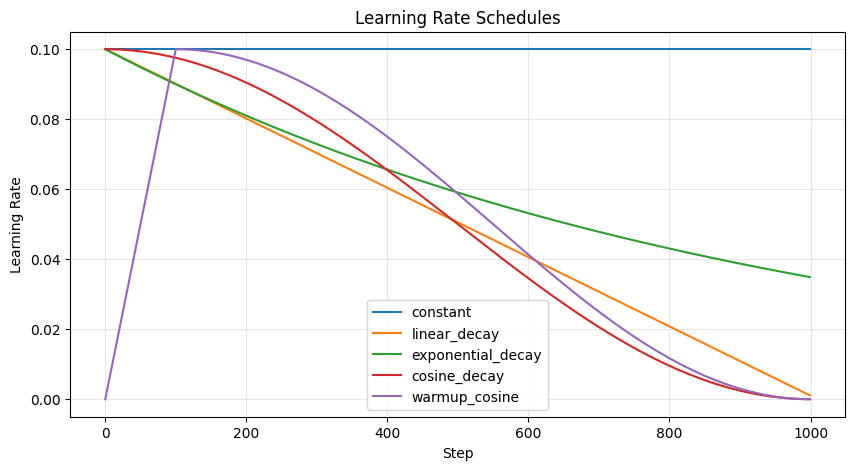
Optax provides various learning rate schedules that can be combined with optimizers.
# Available schedules
n_steps = 1000
steps = jnp.arange(n_steps)

schedules = {
    'constant': optax.constant_schedule(0.1),
    'linear_decay': optax.linear_schedule(
        init_value=0.1, end_value=0.001, transition_steps=n_steps
    ),
    'exponential_decay': optax.exponential_decay(
        init_value=0.1, transition_steps=100, decay_rate=0.9
    ),
    'cosine_decay': optax.cosine_decay_schedule(
        init_value=0.1, decay_steps=n_steps
    ),
    'warmup_cosine': optax.warmup_cosine_decay_schedule(
        init_value=0.0, peak_value=0.1, warmup_steps=100, decay_steps=n_steps
    ),
}

# Plot schedules
plt.figure(figsize=(10, 5))
for name, schedule in schedules.items():
    lrs = [schedule(i) for i in range(n_steps)]
    plt.plot(lrs, label=name)

plt.xlabel('Step')
plt.ylabel('Learning Rate')
plt.title('Learning Rate Schedules')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
# Using a schedule with an optimizer
schedule = optax.warmup_cosine_decay_schedule(
    init_value=0.0,
    peak_value=0.1,
    warmup_steps=50,
    decay_steps=500
)

optimizer = optax.adam(learning_rate=schedule)

# Optimize
params = jnp.array([-1.0, 1.0])
opt_state = optimizer.init(params)
losses_scheduled = []

for step in range(500):
    loss = rosenbrock(params)
    losses_scheduled.append(loss)
    grads = grad(rosenbrock)(params)
    updates, opt_state = optimizer.update(grads, opt_state, params)
    params = optax.apply_updates(params, updates)

print(f"Final loss: {losses_scheduled[-1]:.6f}")
print(f"Final params: ({float(params[0]):.4f}, {float(params[1]):.4f})")
Final loss: 0.000000
Final params: (0.9998, 0.9996)
4. Gradient Transformations#
Optax provides gradient transformations that can be applied before optimization:
clip_by_global_norm- Clip gradients by global normclip- Clip gradients element-wisescale- Scale gradientsadd_noise- Add noise to gradientszero_nans- Replace NaNs with zeros
# Example: Gradient clipping prevents exploding gradients
def unstable_loss(x):
    """Loss function with potentially large gradients."""
    return jnp.exp(x) - 10 * x

x = jnp.array(5.0)  # Large x gives large gradient
raw_grad = grad(unstable_loss)(x)
print(f"Raw gradient at x=5: {float(raw_grad):.2f}")

# Clip gradient
clipped_grad, _ = optax.clip_by_global_norm(1.0).update(raw_grad, None)
print(f"Clipped gradient (max norm=1): {float(clipped_grad):.4f}")
Raw gradient at x=5: 138.41
Clipped gradient (max norm=1): 1.0000
5. Chaining Transforms with optax.chain#
The power of optax comes from composing transforms. A typical chain:
Clip gradients (prevent explosions)
Apply optimizer (compute updates)
Scale by learning rate schedule
# Build a custom optimizer with chained transforms
optimizer = optax.chain(
    optax.clip_by_global_norm(1.0),      # 1. Clip gradients
    optax.scale_by_adam(),                # 2. Adam scaling (no LR yet)
    optax.scale_by_schedule(              # 3. Apply LR schedule
        optax.warmup_cosine_decay_schedule(
            init_value=0.0,
            peak_value=0.01,
            warmup_steps=50,
            decay_steps=500
        )
    ),
    optax.scale(-1.0)                     # 4. Negate (gradient descent)
)

# This is equivalent to:
# optimizer = optax.adam(learning_rate=schedule)  # but with clipping

print("Custom optimizer created with:")
print("  - Gradient clipping (max norm = 1.0)")
print("  - Adam moment scaling")
print("  - Warmup + cosine decay schedule")
Custom optimizer created with:
  - Gradient clipping (max norm = 1.0)
  - Adam moment scaling
  - Warmup + cosine decay schedule
# Common pre-built combinations
print("Pre-built optimizer combinations:")
print()

# AdamW = Adam + weight decay (better for deep learning)
adamw = optax.adamw(learning_rate=0.001, weight_decay=0.01)
print("adamw: Adam with decoupled weight decay")

# Lion = newer optimizer, often better than Adam
lion = optax.lion(learning_rate=0.0001)
print("lion: Evolved Sign Momentum optimizer")

# Noisy SGD for escaping local minima
noisy_sgd = optax.chain(
    optax.add_noise(eta=0.01, gamma=0.55, seed=42),
    optax.sgd(learning_rate=0.01)
)
print("noisy_sgd: SGD with gradient noise")
Pre-built optimizer combinations:

adamw: Adam with decoupled weight decay
lion: Evolved Sign Momentum optimizer
noisy_sgd: SGD with gradient noise
6. Working with PyTrees (Nested Parameters)#
Optax works seamlessly with nested parameter structures (PyTrees).
# Neural network-style parameters
params = {
    'layer1': {
        'weights': jnp.array([[1.0, 2.0], [3.0, 4.0]]),
        'bias': jnp.array([0.1, 0.2])
    },
    'layer2': {
        'weights': jnp.array([[0.5, 0.5]]),
        'bias': jnp.array([0.0])
    }
}

def model(params, x):
    """Simple 2-layer network."""
    h = jnp.tanh(x @ params['layer1']['weights'] + params['layer1']['bias'])
    return h @ params['layer2']['weights'].T + params['layer2']['bias']

def loss_fn(params, x, y):
    pred = model(params, x)
    return jnp.mean((pred - y) ** 2)

# Generate data
key = jax.random.PRNGKey(0)
X = jax.random.normal(key, (100, 2))
y = jnp.sum(X, axis=1, keepdims=True)  # Target: sum of inputs

# Optimize
optimizer = optax.adam(0.01)
opt_state = optimizer.init(params)

@jit
def train_step(params, opt_state, X, y):
    loss, grads = jax.value_and_grad(loss_fn)(params, X, y)
    updates, opt_state = optimizer.update(grads, opt_state, params)
    params = optax.apply_updates(params, updates)
    return params, opt_state, loss

losses = []
for step in range(200):
    params, opt_state, loss = train_step(params, opt_state, X, y)
    losses.append(loss)
    if step % 50 == 0:
        print(f"Step {step}: loss = {float(loss):.6f}")

print(f"\nFinal loss: {float(losses[-1]):.6f}")
Step 0: loss = 0.758675
Step 50: loss = 0.503679
Step 100: loss = 0.391077
Step 150: loss = 0.265704

Final loss: 0.164910
7. Chemical Engineering Example: Reaction Kinetics Fitting#
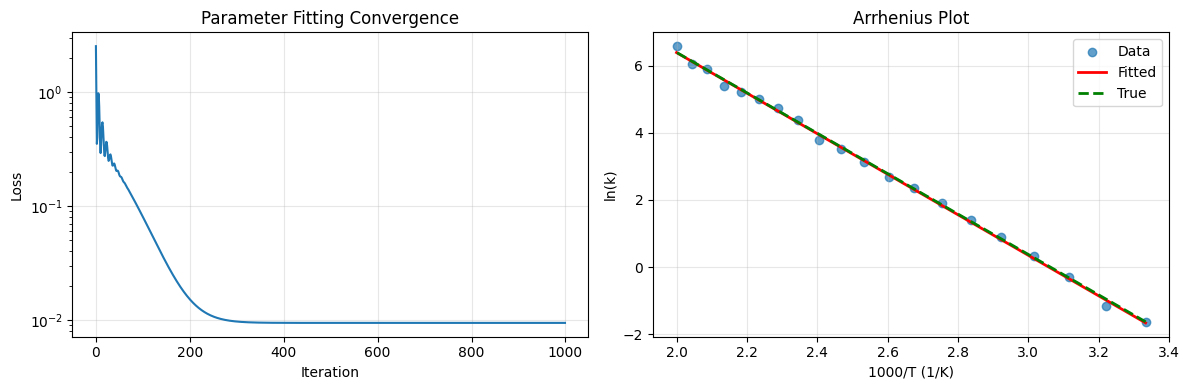
Fit Arrhenius parameters to experimental reaction rate data.
# Arrhenius equation: k = A * exp(-Ea / (R * T))
R_gas = 8.314  # J/(mol·K)

def arrhenius(params, T):
    """Arrhenius rate constant.

    params: dict with 'log_A' and 'Ea_kJ' (Ea in kJ/mol for better scaling)
    T: temperature in K
    """
    A = jnp.exp(params['log_A'])  # Pre-exponential factor
    Ea = params['Ea_kJ'] * 1000   # Convert kJ/mol to J/mol
    return A * jnp.exp(-Ea / (R_gas * T))

# True parameters (what we want to find)
# Note: Ea_kJ = 50 corresponds to 50,000 J/mol = 50 kJ/mol
true_params = {'log_A': jnp.log(1e8), 'Ea_kJ': 50.0}

# Generate synthetic data
T_data = jnp.linspace(300, 500, 20)  # Temperature range
k_true = arrhenius(true_params, T_data)
noise = jax.random.normal(jax.random.PRNGKey(42), T_data.shape) * 0.1
k_data = k_true * jnp.exp(noise)  # Log-normal noise

print(f"True parameters: A = {jnp.exp(true_params['log_A']):.2e}, Ea = {true_params['Ea_kJ']:.0f} kJ/mol")
print(f"Data: {len(T_data)} points from {T_data[0]:.0f}K to {T_data[-1]:.0f}K")
True parameters: A = 1.00e+08, Ea = 50 kJ/mol
Data: 20 points from 300K to 500K
# Loss function: minimize squared error in log space (better for rate constants)
def loss_fn(params, T_data, k_data):
    k_pred = arrhenius(params, T_data)
    return jnp.mean((jnp.log(k_pred) - jnp.log(k_data)) ** 2)

# Initial guess (intentionally wrong)
params = {'log_A': jnp.log(1e6), 'Ea_kJ': 40.0}
print(f"Initial guess: A = {jnp.exp(params['log_A']):.2e}, Ea = {params['Ea_kJ']:.0f} kJ/mol")
print(f"Initial loss: {loss_fn(params, T_data, k_data):.4f}")

# Optimize with Adam using a learning rate schedule for better convergence
# Start with higher LR, decay as we approach minimum
schedule = optax.exponential_decay(
    init_value=0.5,
    transition_steps=100,
    decay_rate=0.9
)
optimizer = optax.adam(learning_rate=schedule)
opt_state = optimizer.init(params)

@jit
def step(params, opt_state):
    loss, grads = jax.value_and_grad(loss_fn)(params, T_data, k_data)
    updates, opt_state = optimizer.update(grads, opt_state, params)
    params = optax.apply_updates(params, updates)
    return params, opt_state, loss

losses = []
for i in range(1000):
    params, opt_state, loss = step(params, opt_state)
    losses.append(loss)

print(f"\nFitted parameters:")
print(f"  A  = {jnp.exp(params['log_A']):.2e} (true: {jnp.exp(true_params['log_A']):.2e})")
print(f"  Ea = {params['Ea_kJ']:.1f} kJ/mol (true: {true_params['Ea_kJ']:.1f} kJ/mol)")
print(f"Final loss: {losses[-1]:.6f}")
Initial guess: A = 1.00e+06, Ea = 40 kJ/mol
Initial loss: 2.5262
Fitted parameters:
  A  = 1.03e+08 (true: 1.00e+08)
  Ea = 50.2 kJ/mol (true: 50.0 kJ/mol)
Final loss: 0.009460
# Plot results
fig, axes = plt.subplots(1, 2, figsize=(12, 4))

# Convergence
ax = axes[0]
ax.semilogy(losses)
ax.set_xlabel('Iteration')
ax.set_ylabel('Loss')
ax.set_title('Parameter Fitting Convergence')
ax.grid(True, alpha=0.3)

# Arrhenius plot (ln(k) vs 1/T)
ax = axes[1]
inv_T = 1000 / T_data  # 1000/T for better axis scale
ax.scatter(inv_T, jnp.log(k_data), label='Data', alpha=0.7)
ax.plot(inv_T, jnp.log(arrhenius(params, T_data)), 'r-',
        label='Fitted', linewidth=2)
ax.plot(inv_T, jnp.log(arrhenius(true_params, T_data)), 'g--',
        label='True', linewidth=2)
ax.set_xlabel('1000/T (1/K)')
ax.set_ylabel('ln(k)')
ax.set_title('Arrhenius Plot')
ax.legend()
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()

# Print parameter comparison
print(f"\nParameter recovery:")
print(f"  log(A): fitted={params['log_A']:.2f}, true={true_params['log_A']:.2f}")
print(f"  Ea_kJ: fitted={params['Ea_kJ']:.2f}, true={true_params['Ea_kJ']:.2f}")
Parameter recovery:
  log(A): fitted=18.45, true=18.42
  Ea_kJ: fitted=50.16, true=50.00
8. Multi-Optimizer Strategies#
Sometimes different parameter groups need different optimizers (e.g., different learning rates).
# Use optax.multi_transform for different learning rates per parameter group
from optax import multi_transform, masked

# With proper parameter scaling, a single optimizer works well
# But multi_transform is useful when parameters need different optimization strategies

# Reset parameters to initial guess
params = {
    'log_A': jnp.log(1e6),   # log scale
    'Ea_kJ': 40.0            # kJ/mol scale
}

# Use learning rate schedules for each parameter
schedule = optax.exponential_decay(init_value=0.5, transition_steps=100, decay_rate=0.9)

optimizer = optax.multi_transform(
    transforms={
        'log_A': optax.adam(schedule),
        'Ea_kJ': optax.adam(schedule),
    },
    param_labels={'log_A': 'log_A', 'Ea_kJ': 'Ea_kJ'}
)

opt_state = optimizer.init(params)

# Run optimization
for i in range(1000):
    loss, grads = jax.value_and_grad(loss_fn)(params, T_data, k_data)
    updates, opt_state = optimizer.update(grads, opt_state, params)
    params = optax.apply_updates(params, updates)

print("Multi-optimizer result:")
print(f"  A  = {jnp.exp(params['log_A']):.2e} (true: {jnp.exp(true_params['log_A']):.2e})")
print(f"  Ea = {params['Ea_kJ']:.1f} kJ/mol (true: {true_params['Ea_kJ']:.1f} kJ/mol)")
Multi-optimizer result:
  A  = 1.03e+08 (true: 1.00e+08)
  Ea = 50.2 kJ/mol (true: 50.0 kJ/mol)
9. Early Stopping and Checkpointing#
Practical training often needs early stopping when validation loss stops improving.
def train_with_early_stopping(params, optimizer, loss_fn,
                               max_steps=1000, patience=50, min_delta=1e-6):
    """Train with early stopping.

    Args:
        patience: Number of steps without improvement before stopping
        min_delta: Minimum improvement to count as progress
    """
    opt_state = optimizer.init(params)
    best_loss = float('inf')
    best_params = params
    steps_without_improvement = 0
    losses = []

    for step in range(max_steps):
        loss, grads = jax.value_and_grad(loss_fn)(params)
        updates, opt_state = optimizer.update(grads, opt_state, params)
        params = optax.apply_updates(params, updates)
        losses.append(float(loss))

        # Check for improvement
        if loss < best_loss - min_delta:
            best_loss = loss
            best_params = params
            steps_without_improvement = 0
        else:
            steps_without_improvement += 1

        # Early stopping
        if steps_without_improvement >= patience:
            print(f"Early stopping at step {step} (no improvement for {patience} steps)")
            break

    return best_params, losses

# Example
params = jnp.array([5.0, 5.0])  # Start far from minimum
optimizer = optax.adam(0.1)

best_params, losses = train_with_early_stopping(
    params, optimizer, rosenbrock,
    max_steps=1000, patience=100
)

print(f"Best params: ({float(best_params[0]):.4f}, {float(best_params[1]):.4f})")
print(f"Final loss: {rosenbrock(best_params):.6f}")
Best params: (2.6871, 7.2228)
Final loss: 2.846791
10. Summary#
Key Optax Functions#
Function |
Purpose |
|---|---|
|
Create optimizers |
|
Initialize optimizer state |
|
Compute updates |
|
Apply updates |
|
Combine transforms |
|
Gradient clipping |
|
Learning rate decay |
|
Different optimizers per param |
Best Practices#
Start with Adam - Works well for most problems
Use learning rate schedules - Warmup + decay often helps
Clip gradients - Prevents training instabilities
JIT compile train_step - Major speedup
Log-transform rate constants - Better optimization landscape
When to Use What#
Scenario |
Optimizer |
|---|---|
General purpose |
|
Deep learning |
|
Large-scale |
|
Convex problems |
|
Parameter estimation |
|